ChatGPT možda ne halucinira — možda je pročitao pogrešnu stranicu
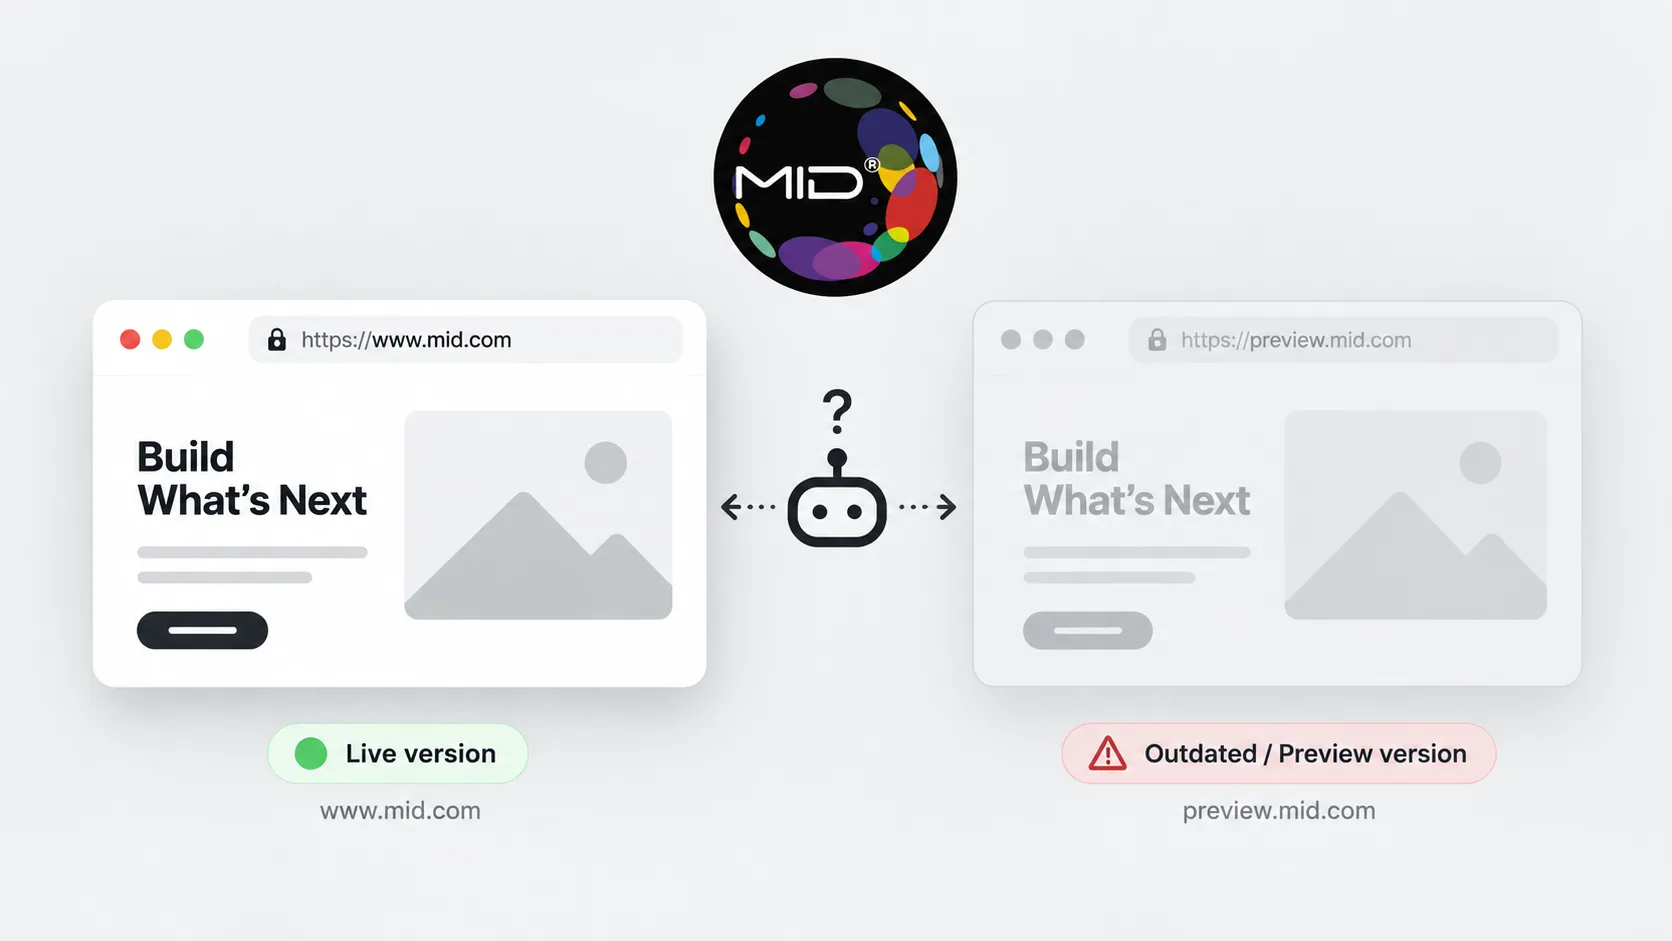
AI sustav može dati pogrešan odgovor o tvrtki zato što je pronašao zastarjelu, testnu ili preview verziju njezina weba. Problem tada nije nužno u tome da je model izmislio informaciju, nego u tome što mu je web omogućio pristup izvoru koji više ne predstavlja stvarno stanje poslovanja.
Cloudflare je na vlastitoj dokumentaciji otkrio vrlo konkretan primjer ovog problema. Tvrtka za svaki GitHub pull request automatski generira privremenu preview verziju dokumentacije kako bi developeri mogli provjeriti izmjene prije objave. Te stranice mogu sadržavati nepotpune ili još nepotvrđene informacije.
U studenom 2025. Cloudflare je kroz AI Crawl Control otkrio da je čak 80% AI crawlova njihove dokumentacije odlazilo na preview stranice umjesto na glavnu produkcijsku stranicu. To je značilo da AI sustavi mogu koristiti informacije koje još nisu ni bile službeno objavljene. Cloudflare izravno navodi da su takvi odgovori korisnicima mogli izgledati kao AI halucinacije.
Nakon što je Cloudflare dodao robots.txt pravila na preview stranice, udio crawlova prema njima pao je s 80% na 20%. Kada su zatim implementirali sigurnosno pravilo koje je crawlerima potpuno blokiralo pristup preview verzijama, broj crawlova tih stranica pao je s 20% na 0%.
To je velika razlika između „AI ne razumije našu tvrtku” i „AI dobiva pogrešan izvor”.
Zato MID audit weba ne treba promatrati samo kao klasičnu SEO provjeru. Audit provjerava kako AI sustavi vide i razumiju javno dostupan sadržaj weba te može pomoći otkriti situacije u kojima struktura, sadržaj ili dostupni URL-ovi AI-ju šalju nejasne ili međusobno proturječne informacije.
AI može potpuno ispravno pročitati pogrešnu stranicu i zbog toga dati potpuno pogrešan odgovor o vašoj tvrtki.
Problem postaje još važniji kako se povećava važnost AI Searcha i prometa koji dolazi iz AI pretraživača. Ako želite da ChatGPT, Gemini ili drugi sustav preporuči vašu tvrtku, nije dovoljno samo omogućiti crawlanje. Morate kontrolirati što točno crawler može pronaći.
Koju pogrešnu verziju weba AI može pronaći?
Web stranica može istodobno imati više javno dostupnih verzija istog ili sličnog sadržaja. Čovjek najčešće otvara domenu preko Googlea, navigacije ili izravnog linka i uglavnom završi na aktualnoj stranici. Crawler sustavno slijedi URL-ove i može doći do mjesta koja prosječan korisnik nikada neće vidjeti.
To mogu biti razvojne poddomene poput staging.example.hr, automatski deployment preview URL-ovi, stari proizvodi koji više nisu u navigaciji, stare verzije cjenika, testne stranice, duplicirani URL-ovi s parametrima ili arhivirane stranice koje server i dalje vraća sa statusom 200.
Posebno je problematično kada dvije javno dostupne stranice daju različite činjenice.
Primjerice, glavna stranica navodi da tvrtka pruža pet usluga, a stara landing stranica navodi sedam. Novi cjenik kaže jednu cijenu, a stari PDF drugu. Produkcijska stranica navodi novi kontakt, ali preview verzija još sadrži prethodni broj telefona.
AI tada mora odlučiti koji je izvor vjerodostojniji.
Ako tehnički signali nisu jasni, odgovor ne mora biti onaj koji vlasnik weba očekuje.
Ovaj problem je usko povezan s kontrolom AI crawlera. U članku o tome kako postići ChatGPT vidljivost bez dopuštanja AI treniranja razdvajamo svrhu pojedinih crawlera. Ovdje je sljedeće pitanje još konkretnije: ako ste crawleru omogućili pristup, jeste li mu omogućili pristup pravim stranicama?
Kako provjeriti koje stranice AI može čitati?
- Popišite produkcijske, staging, preview i stare poddomene koje su još javno dostupne.
- Provjerite vraćaju li zastarjele i testne stranice status 200 te mogu li ih crawleri normalno otvoriti.
- Provjerite robots.txt, canonical, noindex, sitemap i sigurnosna pravila za svaku verziju weba.
| Kontrola | Što govori crawleru | Blokira pristup? | | -------------------- | ------------------------------------------- | ---------------- | | robots.txt | koju putanju crawler ne bi trebao posjetiti | ne nužno | | canonical | koja je preferirana verzija sadržaja | ne | | noindex | da se stranica ne indeksira | ne | | WAF / access pravilo | da zahtjev ne smije do sadržaja | da |
Cloudflare posebno upozorava da robots.txt nije sigurnosni mehanizam. Datoteka izražava pravila koja crawler može poštovati, ali sama po sebi tehnički ne sprečava zahtjev. Zato je u njihovom primjeru robots.txt smanjio pristup preview stranicama na 20%, dok ga je sigurnosno pravilo uklonilo u potpunosti.
Canonical više nije važan samo Googleu
Canonical može pomoći AI sustavima razlikovati glavnu stranicu od duplicirane ili zastarjele verzije sadržaja. Sam <link rel="canonical"> i dalje nije zabrana pristupa, ali postaje važan signal u infrastrukturi koja aktivno upravlja AI crawlerima.
Cloudflare je u travnju 2026. predstavio funkciju Redirects for AI Training. Kada verificirani AI training crawler zatraži stranicu koja canonicalom pokazuje na drugi URL iste domene, Cloudflare može crawleru automatski vratiti 301 preusmjeravanje prema canonical verziji.
Zanimljivo je da takvo preusmjeravanje ne mora vrijediti za ljude, klasične tražilice ili AI Search agente. Cloudflare ovu funkciju primjenjuje ciljano na verificirane crawlere kategorije AI Crawler, dok ostali posjetitelji mogu nastaviti dobivati izvornu stranicu.
To pokazuje koliko upravljanje webom postaje granularno.
Prije nekoliko godina canonical smo uglavnom promatrali kroz Google SEO i probleme dupliciranog sadržaja. Danas isti tehnički signal može sudjelovati u odluci koju će verziju sadržaja dobiti crawler koji prikuplja informacije za AI sustav.
Međutim, canonical nije rješenje za staging stranicu koja uopće ne bi trebala biti javno dostupna.
Ako preview.example.hr sadrži interne, nepotpune ili netočne informacije, ispravniji pristup može biti onemogućiti crawlerima pristup toj domeni ili je zaštititi autentikacijom. Cloudflare upravo iz svog slučaja preporučuje da preview stranice budu zaštićene ako ne želite da postanu izvor za AI odgovore.
Kod izrade web stranica zato više nije dovoljno provjeriti samo izgleda li produkcijski URL ispravno. Potrebno je provjeriti što je ostalo javno dostupno izvan glavne navigacije, sitemapa i korisničkog toka.
noindex također nije isto što i zabrana crawlanja
noindex govori sustavu da sadržaj ne bi trebao biti indeksiran, ali crawler prvo mora otvoriti stranicu kako bi pročitao tu direktivu. OpenAI primjerice navodi da, ako ne želite da se određeni URL pojavi ni kao naslov i link u određenim ChatGPT iskustvima, možete koristiti noindex, ali njihov crawler mora imati pristup stranici kako bi taj meta tag mogao pročitati.
To je čest izvor tehničkog nesporazuma.
Ako istodobno potpuno zabranite crawleru pristup u robots.txt i očekujete da će crawler pročitati noindex koji se nalazi unutar HTML-a, ta dva pravila mogu raditi jedno protiv drugoga.
Zato se tehnička pravila moraju promatrati zajedno, a ne pojedinačno.
Za javni članak možda želite crawling, canonical i indeksaciju. Za stari proizvod možda želite redirect. Za testnu stranicu možda želite noindex. Za privatni preview deployment možda ne želite da AI crawler do sadržaja uopće dođe.
MID audit u tom kontekstu ima jednostavan cilj: provjeriti što AI sustav može razumjeti iz onoga što mu je stvarno dostupno, a ne samo ono što vlasnik weba misli da je objavio.
To je sve važnije jer AI Crawl Control danas može prikazati crawler aktivnost prema konkretnim hostnameovima i URL putanjama. Cloudflare omogućuje filtriranje prometa prema crawleru, operatoru, hostnameu i pathu te praćenje kršenja robots.txt pravila.
Drugim riječima, više nije potrebno nagađati posjećuju li AI crawler-i zaboravljeni dio weba. Na infrastrukturi koja takve podatke prati to se može izravno izmjeriti.
Izvor istine za AI mora biti isti kao izvor istine za kupca
Tvrtka treba definirati jednu aktualnu verziju ključnih poslovnih informacija. AI crawler ne zna da je određena landing stranica „samo stari test” ako mu to tehnička struktura weba ne pokaže.
Cijene, lokacije, kontaktni podaci, usluge, dostupnost, specifikacije proizvoda i poslovna pravila zato ne bi trebali ostati aktivni na napuštenim URL-ovima bez jasnog razloga.
Što web ima više godina, migracija i redizajna, veća je mogućnost da iza njega postoji tehnički trag starih stranica.
To je posebno važno kod React aplikacija, vlastitih administracijskih sustava i webova koji imaju staging ili automatske preview deploymente. Takve funkcionalnosti ubrzavaju razvoj, ali moraju biti pravilno odvojene od javne produkcije.
AI razumije ono što mu je dostupno.
Ako mu istodobno ponudite tri verzije iste činjenice, nije realno očekivati da će uvijek odabrati onu koju vi smatrate službenom.